Игра
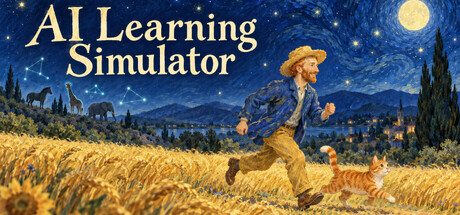
AI Learning Simulator
Где дешевле
41 регион-
 Австрия 0 € Бесплатно
-
 Швейцария 0 CHF Бесплатно
-
 ОАЭ 0 AED Бесплатно
-
 Соединенные Штаты ваш регион 0 $ Бесплатно
Описание
Бесплатная лаборатория обучения искусственному интеллекту. Спроектируйте тело животного и позвольте нейронным сетям обнаружить движение посредством нескольких поколений испытаний. Узнайте, как входные данные, контроль и оценка формируют поведение. Сохраняйте, сравнивайте и делитесь результатами.
Сделать процесс обучения ИИ видимым
У кошки есть тело, суставы и двигательные органы. Теперь ему нужно найти способ двигаться вперед.
Первые попытки могут быть неуклюжими: конечности мешают друг другу, теряется равновесие, большие усилия почти не приводят к движению. После многих поколений испытаний некоторые действия начинают приносить полезные перемещения. Некоторые стратегии контроля сохраняются, но могут появиться новые способы перемещения.
AI Learning Simulator — бесплатная игра для обучения и наблюдения, основанная на физике. Создавайте тела, настраивайте параметры, запускайте обучение и наблюдайте, как нейронные сети ищут эффективное поведение в рамках ограничений тела и его окружения.
Каждое улучшение может стать конкретным экспериментом в области искусственного интеллекта.
Спроектируйте тело, а затем наблюдайте, как оно учится
Начните с кошки, слона, жирафа, лошади или двуногого. Отрегулируйте размер, пропорции и вес конечностей или более подробно отредактируйте сегменты костей, суставы и точки крепления привода.
Эти параметры напрямую меняют проблему обучения.
Более длинные ноги меняют как диапазон движений, так и условия равновесия. Более тяжелое тело увеличивает нагрузку. Перемещение точек крепления привода изменяет его моментный рычаг вокруг шарнира. Один и тот же контроллер может давать совершенно разные результаты в разных телах.
Движение возникает в результате совокупного воздействия структуры тела, возможностей исполнительных механизмов и стратегии управления.
Скелет определяет, как тело может двигаться, приводы подают силу, а нейронная сеть организует управляющие сигналы со своих входов. Текстуры придают персонажу внешний вид; движение должно проявить себя в физическом моделировании.
Как нейронная сеть превращает состояния в действия
В текущей модели управления сеть получает относительное удлинение каждого линейного привода. Эти числовые значения служат способом наблюдения за состоянием тела.
Значения передаются по связям с разными весами. У нейронов также есть смещения и функции активации. Для одного нейрона вычисление можно представить так:
Выход = функция активации (Σ(вход × вес связи) + смещение)
Веса определяют влияние каждого входа. Смещение меняет реакцию нейрона. Функции активации позволяют сети формировать более сложные нелинейные отношения.
Узлы и соединения работают вместе, создавая управляющие выходы для исполнительных механизмов. Изменение параметров сети меняет реакцию организма на одно и то же состояние.
Каждая поднятая нога, момент опоры или потеря равновесия соответствуют последовательности числовых вычислений и физической обратной связи.
Движение формируется благодаря постоянной обратной связи
Управление не заканчивается после однократного расчета.
Состояния привода попадают в сеть. Он выдает управляющие сигналы. Приводы перемещают суставы. Гравитация и контакт с землей влияют на тело. Полученное состояние становится входными данными для следующего расчета.
Этот цикл продолжается:
Состояние тела → нейронная сеть → управление исполнительными механизмами → физическое движение → новое состояние тела
Эффект выхода также зависит от текущей позы тела, движения и условий контакта. Одно и то же действие может иметь разные последствия, когда нога раскачивается в воздухе и когда она касается земли.
Ритм походки и координация могут постепенно возникать благодаря обратной связи между контроллером, телом и окружающей средой. Наблюдение за движением также означает наблюдение за работой этого замкнутого цикла.
Как обучение меняет поведение
В первую очередь игра ищет стратегии управления посредством нейроэволюции.
При обучении оценивается совокупность сетей-кандидатов. С разными параметрами управления каждый пытается двигаться в своей собственной физической симуляции. После каждого поколения система сравнивает производительность, позволяет лучшим стратегиям влиять на следующее поколение и вводит новые попытки посредством мутации.
Процесс повторяется:
- 1. Сгенерировать совокупность кандидатов в управляющие сети.
- 2. Провести физические испытания в течение фиксированной продолжительности.
- 3. Оценить выполнение движений.
- 4. Сохраните некоторые лучшие стратегии и создайте модифицированные сети.
- 5. Проверьте еще раз и продолжите сравнение.
Изменения могут повлиять на веса соединений и смещения нейронов, а также добавить узлы и соединения. Сама структура сети может быть частью поиска.
Важное отличие: во время испытания контроллер неоднократно производит расчет со своими текущими параметрами. Между поколениями обучение ищет новые параметры посредством отбора и мутации.
Движущийся символ показывает реализацию текущей стратегии. Различия между поколениями показывают результаты обучения.
То, чему он учится, зависит от того, как мы его оцениваем
Текущая основная задача — продвинуться как можно дальше вперед за фиксированное время. Производительность оценивается в основном по самому дальнему горизонтальному положению, которого достиг персонаж.
Этот простой объектив может дать множество интересных наблюдений.
Идти дальше не обязательно означает двигаться более естественно. Хорошие результаты в коротком испытании не гарантируют стабильности в более длительном. Сила и энергия сковывают действия, но расстояние, элегантность движений и энергоэффективность остаются разными целями.
Обучение подталкивает определяемый нами показатель к улучшению. Будет ли этот показатель полностью соответствовать нашим ожиданиям — вопрос для человека, планирующего эксперимент.
Когда возникает неожиданное движение, оглянитесь назад: какие входные данные мы предоставили, какие действия мы разрешили и какие правила мы использовали для определения успеха?
Понимание этих вопросов является частью понимания искусственного интеллекта.
Обучение может застопориться и ограничивается своими условиями
Прогресс во время обучения редко бывает равномерным.
Иногда целая серия попыток оказывается неэффективной. Иногда небольшое изменение приводит к явному улучшению. В других случаях производительность может оставаться одинаковой на протяжении многих поколений.
Размер популяции влияет на количество попыток, мутация влияет на степень исследования, а структура тела определяет возможное перемещение. Чем больше поколений, тем больше возможностей для поиска, но они не могут гарантировать, что каждый человек научится стабильно ходить.
Больше нейронов не означает автоматически лучшую стратегию.
Интерпретируйте каждый результат с учётом строения тела, возможностями привода, продолжительностью оценки и правилами подсчета очков. Подсчет поколений показывает, сколько раундов оценки было проведено; о реальных способностях по-прежнему следует судить по результатам.
Измените условия, тренируйтесь заново и сравните результаты разных экспериментов.
Сохраните свои эксперименты
Игра предлагает полный путь от дизайна до обмена:
- Выберите шаблон тела: начните с кошки, слона, жирафа, лошади или двуногого.
- Отрегулируйте конструкцию корпуса и привода: измените размер, пропорции и вес; редактировать соединения и точки крепления привода.
- Настройте обучение: отрегулируйте размер популяции, продолжительность оценки и параметры эволюции и наблюдайте за их эффектами.
- Проверка производительности: наблюдение за структурой сети, сигналами исполнительных механизмов, показателями движения и поколениями тренировок.
- Сохраните и продолжите тренировку: сохраните конфигурацию тела и лучшую стратегию, определите результаты по миниатюрам животных и совокупному подсчету поколений, а затем исследуйте дальше, используя сохраненную стратегию.
- Наблюдайте и сравнивайте на одном экране: воспроизводите изученные стратегии двух персонажей независимо друг от друга, чтобы сравнить разные тела или контроллеры.
- Меняйте внешний вид и делитесь: используйте шаблоны скинов животных, людей и книжек с картинками. Загрузите или загрузите скины и результаты обучения через Мастерскую Steam.
Игра включает в себя кошачью стратегию, обученную в общей сложности 280 поколениям. Воспроизведите его напрямую или используйте в качестве отправной точки для дальнейшего обучения и наблюдайте, что изменится.
Попытки кошки раскрыть небольшую часть обучения ИИ
В сценах из книжек с картинками, изображающих лунный свет, звездное небо и пшеничные поля, не торопитесь, наблюдая за стратегией управления, или перепроектируйте тело и начните свой собственный эксперимент.
Казалось бы, простое движение вперед соединяет кодирование входных данных, нейронные вычисления, динамику тела, правила оценки и вероятностный поиск.
Мы надеемся, что эта бесплатная игра превратит абстрактные концепции в процессы, которые вы сможете неоднократно наблюдать, корректировать и тестировать. Выстройте собственное суждение: какую информацию получает система, какие действия она может предпринять и при каких условиях проявляется эффективное поведение?
Разработано Magiccat и доступно бесплатно. Обучение проходит локально на вашем компьютере. Для использования функций Мастерской Steam требуется вход в Steam.
Требования к ПК
Минимальные
- Система
- Windows 10 64-bit
- Процессор
- Intel Core i5-3470 或 AMD FX-8350
- Память
- 0,3 ГБ
- Видеокарта
- NVIDIA GeForce GTX 660 或 AMD Radeon HD 7870
- Место
- 1 ГБ
Рекомендуемые
Requires a 64-bit processor and operating system
Австрия 0 € В вашем регионе 0 $
История цен
- Сейчас
- 0 €
- Минимум
- 0 € · 24 окт.
- Максимум
- 0 €
Цена не менялась с 24 окт.
Об игре
- Разработчик
- Magic Cat
- Издатель
- Magic Cat
- Жанры
- Казуальные,Симуляторы
Языки 2
| Язык | Меню | Голос | Субтитры |
|---|---|---|---|
| Английский | |||
| Китайский, упрощенное письмо |
Другие игры Magic Cat


 125 ₽ Россия
 82 ₽ Россия

 165 ₽ Россия
 42 ₽ Россия
 42 ₽ Россия
 42 ₽ Россия
 42 ₽ Россия
 125 ₽ Россия
 125 ₽ Россия